Season Invariant NetVLAD Loop Closure Detection through Semantic Hard Negative Mining
Authors
Kamil Wysocki, Adrian OstrowskiFiles
Key Information
Journal
Published in Vol. 4 No. 2 (2026) of Journal of Applied Computational Intelligence.
The Journal of Applied Computational Intelligence (JACI) eISSN:3136-6937 is a peer-reviewed, international, open-access journal dedicated to the advancement of computational intelligence methodologies and their real-world applications across diverse engineering and scientific domains. The journal aims to bridge the gap between theoretical development and practical deployment of intelligent systems by providing a scholarly platform for researchers, practitioners, and industry innovators.
JACI encourages high-quality original research, review articles, and technical reports that explore the design, implementation, and optimization of intelligent algorithms for solving complex problems in fields such as manufacturing, energy, healthcare, transportation, and information systems.
Abstract
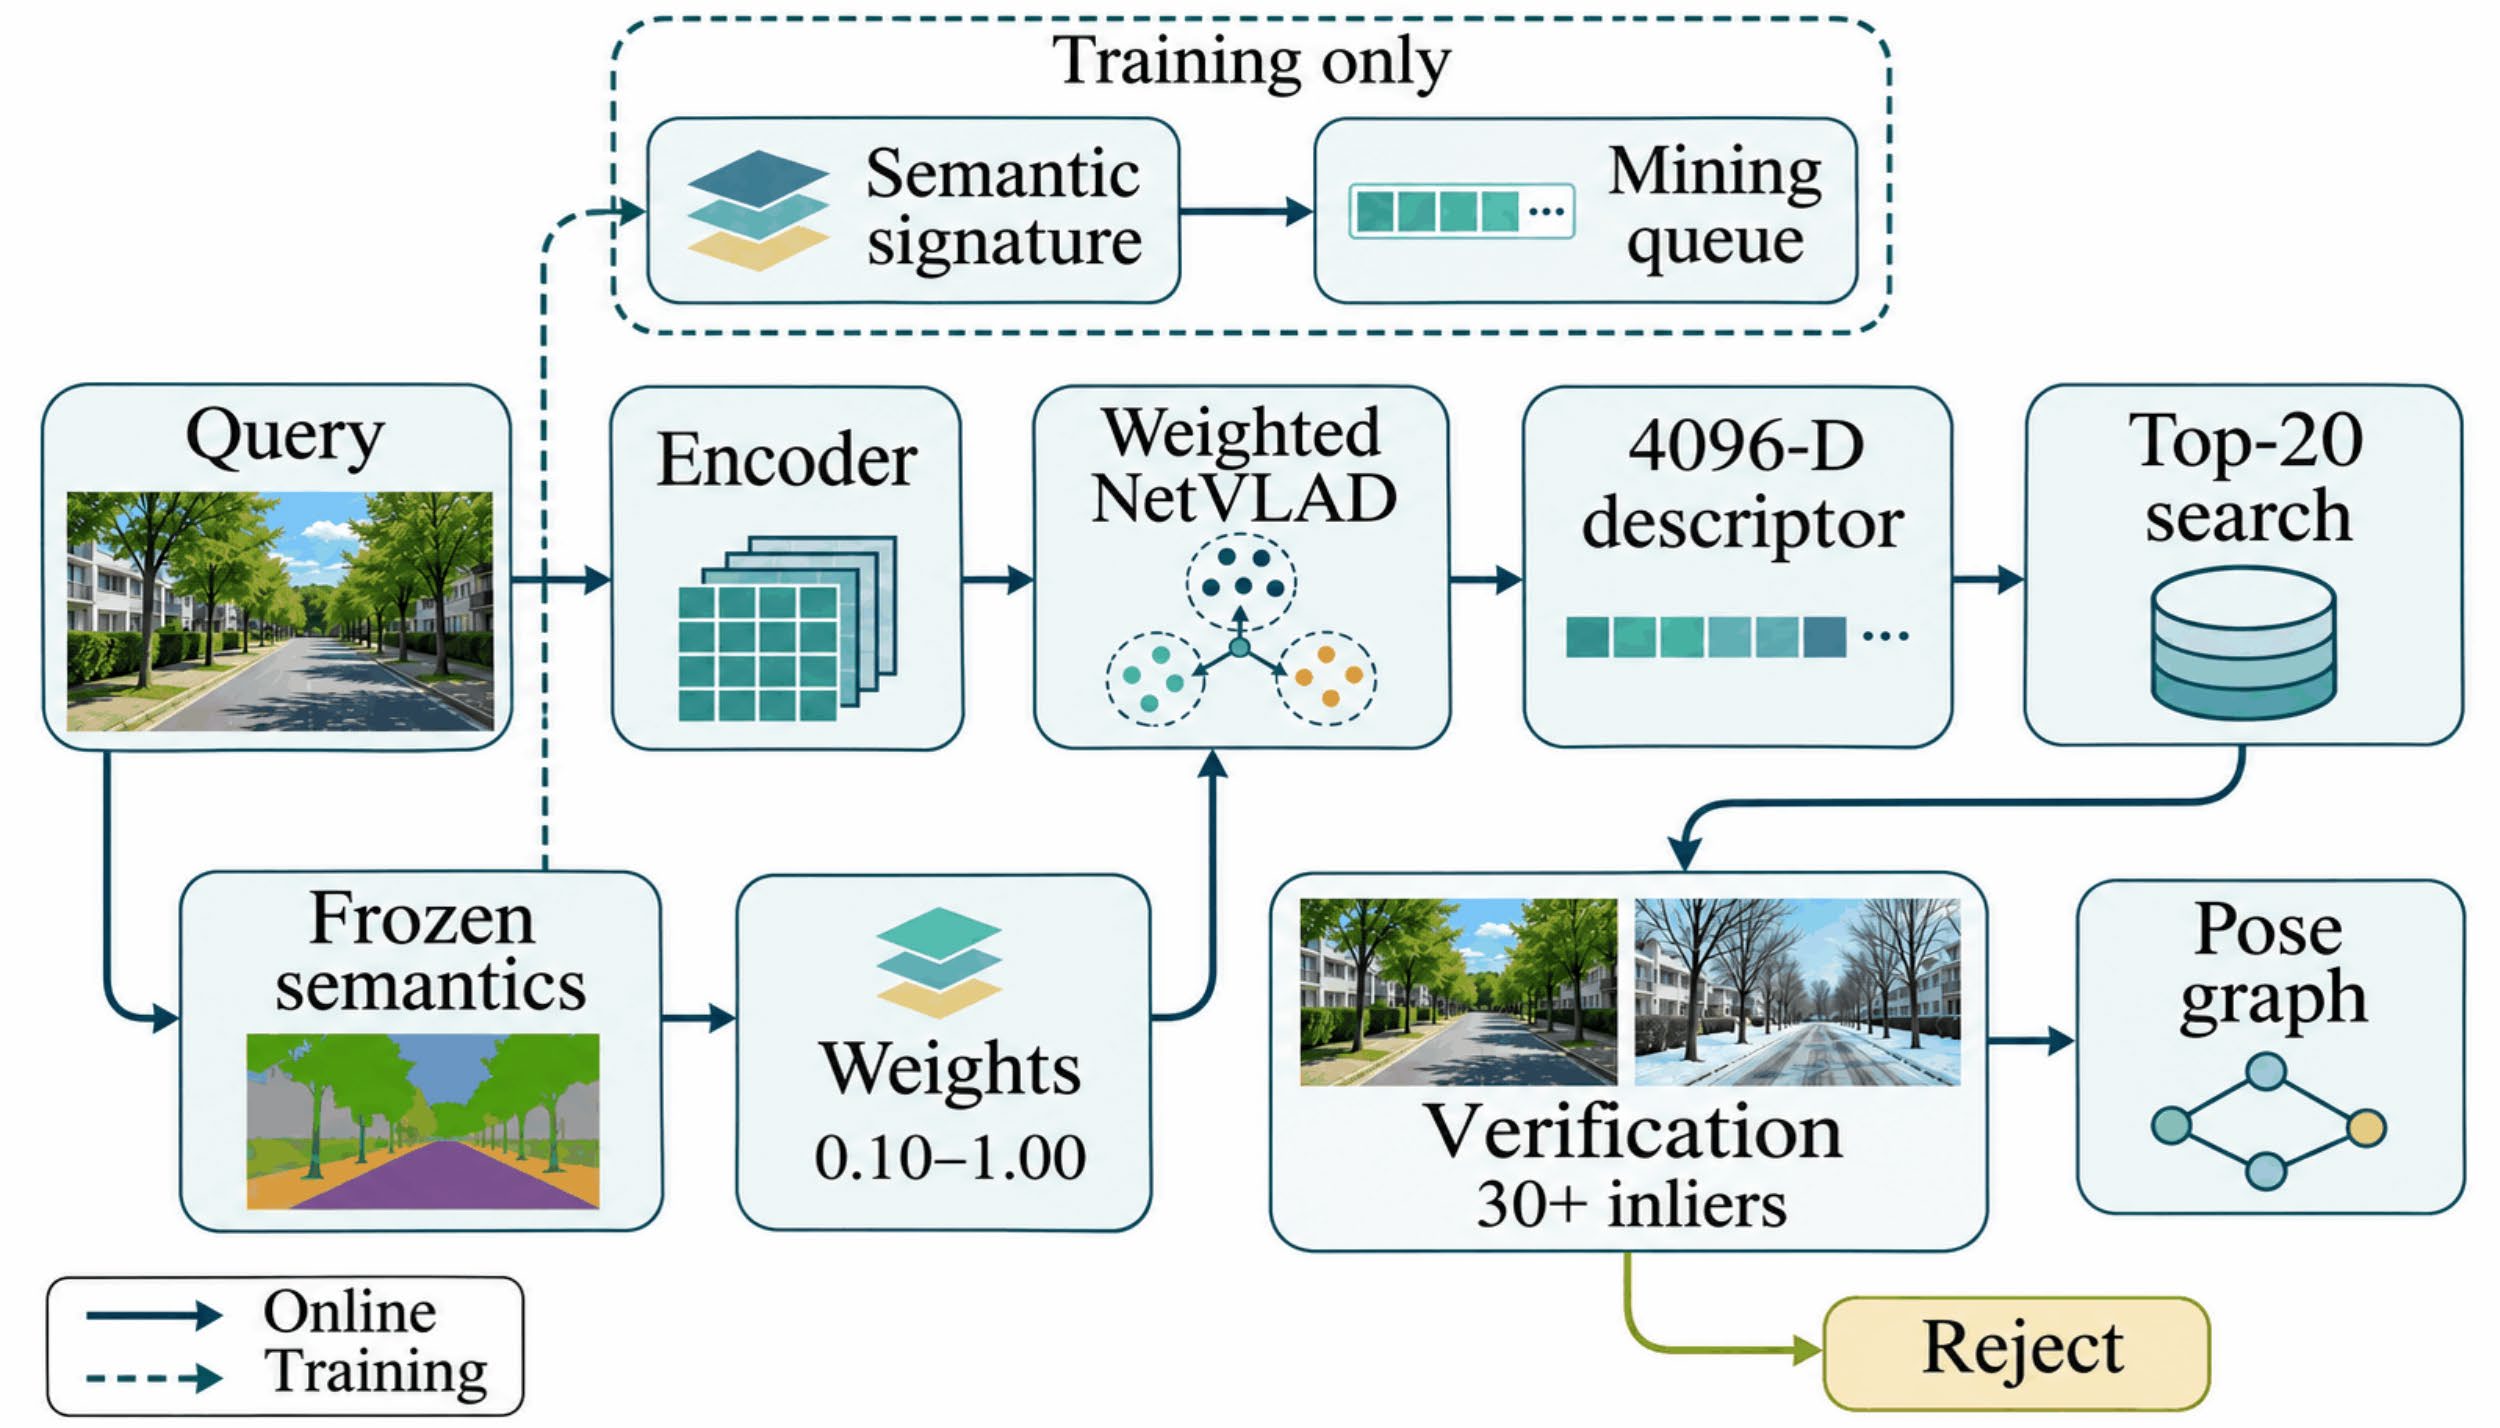
Seasonal appearance changes complicate visual loop closure because corresponding locations can become less similar than geographically unrelated scenes with comparable semantic layouts. This paper develops a semantic hard negative mining framework for a season invariant NetVLAD descriptor. The framework combines confidence weighted structural pooling, geographically guarded candidate selection, and a gradual transition from moderately difficult to difficult training pairs. Semantic similarity identifies informative distractors, while a spatial exclusion region and an uncertainty buffer reduce the risk of treating revisited locations as negatives. The evaluation examines retrieval accuracy, component contributions, and computational resource requirements under a controlled protocol. Across four seasonal transition scenarios, the proposed configuration attains top ranked retrieval recalls of 88.4%, 86.1%, 83.7%, and 81.8%, compared with 79.1%, 76.8%, 73.5%, and 70.2% for the matched NetVLAD baseline. Mean recall therefore increases from 74.9% to 85.0%. The component study assigns 78.0% to structural pooling alone and 81.2% to guarded semantic mining, exposing the complementary roles of feature weighting and sample selection. The configured retrieval pipeline uses a 4096-dimensional descriptor and a median latency of 35.0 ms. Threshold and perturbation analyses examine precision sensitivity, semantic uncertainty, storage growth, and difficult failure cases. The evaluation relates structural feature weighting and training sample selection to retrieval accuracy, verification behavior, and deployment requirements. The mean top-ranked retrieval gain is 10.1 percentage points; this descriptor-level comparison is assessed separately from geometric acceptance of loop candidates.
References
Schubert, S., Neubert, P., Garg, S., Milford, M., & Fischer, T. (2024). Visual place recognition: A tutorial [Tutorial]. IEEE Robotics & Automation Magazine, 31(3), 139–153. https://doi.org/10.1109/mra.2023.3310859
Jiang, H., Piao, S., Yu, H., Li, W., & Yu, L. (2024). Robust visual place recognition for severe appearance changes. IEEE Robotics and Automation Letters, 9(5), 4289–4296. https://doi.org/10.1109/lra.2024.3376967
Keetha, N., Mishra, A., Karhade, J., Jatavallabhula, K. M., Scherer, S., Krishna, M., & Garg, S. (2024). AnyLoc: Towards universal visual place recognition. IEEE Robotics and Automation Letters, 9(2), 1286–1293. https://doi.org/10.1109/lra.2023.3343602
Claxton, O., Malone, C., Carson, H., Ford, J. J., Bolton, G., Shames, I., & Milford, M. (2024). Improving visual place recognition based robot navigation by verifying localization estimates. IEEE Robotics and Automation Letters, 9(12), 11098–11105. https://doi.org/10.1109/lra.2024.3483045
Uggi, A., & Channappayya, S. S. (2024). MS-NetVLAD: Multi-scale NetVLAD for visual place recognition. IEEE Signal Processing Letters, 31, 1855–1859. https://doi.org/10.1109/lsp.2024.3425279
Xiang, L., Fu, H., & Yang, C. (2025). CerfeVPR: Cross-environment robust feature enhancement for visual place recognition. Computers, Materials & Continua, 84(1), 325–345. https://doi.org/10.32604/cmc.2025.062834
Zhao, X., Zhang, Y., Ning, J., Wang, Z., Li, K., & Zou, D. (2025). Semantic boundary constrained network for visual place recognition under adverse conditions. IEEE Transactions on Intelligent Transportation Systems, 26(8), 11823–11834. https://doi.org/10.1109/tits.2025.3576106
Guan, P., Cao, Z., Fan, S., Yang, Y., Yu, J., & Wang, S. (2025). Hardness-aware metric learning with cluster-guided attention for visual place recognition. IEEE Transactions on Circuits and Systems for Video Technology, 35(1), 367–379. https://doi.org/10.1109/tcsvt.2024.3465520
Shen, Y., Zhou, S., Fu, J., Wang, R., Chen, S., & Zheng, N. (2025). StructVPR++: Distill structural and semantic knowledge with weighting samples for visual place recognition. IEEE Transactions on Pattern Analysis and Machine Intelligence, 47(8), 6338–6351. https://doi.org/10.1109/tpami.2025.3556859
Ming, Y., Xu, M., Yang, X., Ye, W., Wang, W., Peng, Y., Dai, W., & Kong, W. (2025). VIPeR: Visual incremental place recognition with adaptive mining and continual learning. IEEE Robotics and Automation Letters, 10(3), 3038–3045. https://doi.org/10.1109/lra.2025.3539093
Chen, C., He, M., Wang, J., & Meng, Z. (2024). GeoCluster: Enhancing visual place recognition in spatial domain on aerial vehicle platforms. IEEE Robotics and Automation Letters, 9(3), 3013–3020. https://doi.org/10.1109/lra.2024.3363536
Grainge, O., Milford, M., Bodala, I., Ramchurn, S. D., & Ehsan, S. (2025). Structured pruning for efficient visual place recognition. IEEE Robotics and Automation Letters, 10(2), 2024–2031. https://doi.org/10.1109/lra.2024.3523222
Xu, Y., Shamsolmoali, P., Zareapoor, M., & Yang, J. (2025). ClusVPR: Efficient visual place recognition with clustering-based weighted transformer. IEEE Transactions on Artificial Intelligence, 6(4), 1038–1049. https://doi.org/10.1109/tai.2024.3510479
Jin, T., Lu, F., Hu, S., Yuan, C., & Liu, Y. (2025). EDTformer: An efficient decoder transformer for visual place recognition. IEEE Transactions on Circuits and Systems for Video Technology, 35(9), 8835–8848. https://doi.org/10.1109/tcsvt.2025.3559084
Kannan, S. S., & Min, B.-C. (2024). PlaceFormer: Transformer-based visual place recognition using multi-scale patch selection and fusion. IEEE Robotics and Automation Letters, 9(7), 6552–6559. https://doi.org/10.1109/lra.2024.3408075
Hou, S., Qin, Z., Wu, C., Yin, G., Wang, X., & Wang, Z. (2025). DIEONet: Domain-invariant information extraction and optimization network for visual place recognition. Computers, Materials & Continua, 82(3), 5019–5033. https://doi.org/10.32604/cmc.2025.058233
Semenkov, I., Karpov, A., Savchenko, A. V., & Makarov, I. (2024). Inpainting semantic and depth features to improve visual place recognition in the wild. IEEE Access, 12, 5163–5176. https://doi.org/10.1109/access.2024.3350038
Wang, S., Kang, Q., She, R., Zhao, K., Song, Y., & Tay, W. P. (2024). PRFusion: Toward effective and robust multi-modal place recognition with image and point cloud fusion. IEEE Transactions on Intelligent Transportation Systems, 25(12), 20523–20534. https://doi.org/10.1109/tits.2024.3465830
Bao, Y., Pan, Y., Yang, Z., & Huan, R. (2024). A hierarchical utilization of semantic gradients and scene structure for visual place recognition. IEEE Transactions on Cognitive and Developmental Systems, 16(2), 570–583. https://doi.org/10.1109/tcds.2023.3281870
Liu, L., Zuo, W., Fu, J., Shen, Y., Xin, J., & Zheng, N. (2025). RankTuning: Cross-image partial tuning strategies for rank optimization in visual place recognition. IEEE Transactions on Intelligent Transportation Systems, 26(12), 23179–23189. https://doi.org/10.1109/tits.2025.3614340
Miller, E., Milford, M., Hafez, M. B., Ramchurn, S., & Ehsan, S. (2026). Through the lens of doubt: Robust and efficient uncertainty estimation for visual place recognition. IEEE Robotics and Automation Letters, 11(5), 5899–5906. https://doi.org/10.1109/lra.2026.3674688
Berton, G., Trivigno, G., Caputo, B., & Masone, C. (2024). JIST: Joint image and sequence training for sequential visual place recognition. IEEE Robotics and Automation Letters, 9(2), 1310–1317. https://doi.org/10.1109/lra.2023.3339058
Yuan, F., Schubert, S., Protzel, P., & Neubert, P. (2024). Local positional graphs and attentive local features for a data and runtime-efficient hierarchical place recognition pipeline. IEEE Robotics and Automation Letters, 9(3), 2686–2693. https://doi.org/10.1109/lra.2024.3359552
Wenzel, P., Yang, N., Wang, R., Zeller, N., & Cremers, D. (2025). 4Seasons: Benchmarking visual SLAM and long-term localization for autonomous driving in challenging conditions. International Journal of Computer Vision, 133(4), 1564–1586. https://doi.org/10.1007/s11263-024-02230-4
Li, P., Wen, S., Xu, C., & Qiu, T. Z. (2024). Visual place recognition for opposite viewpoints and environment changes. IEEE Transactions on Instrumentation and Measurement, 73, 1–9. https://doi.org/10.1109/tim.2024.3350152
Zhao, J., Zhang, F., Cai, Y., Tian, G., Mu, W., Ye, C., & Feng, T. (2024). Learning sequence descriptor based on spatio-temporal attention for visual place recognition. IEEE Robotics and Automation Letters, 9(3), 2351–2358. https://doi.org/10.1109/lra.2024.3354627
Lu, F., Dong, S., Zhang, L., Liu, B., Lan, X., Jiang, D., & Yuan, C. (2024). Deep homography estimation for visual place recognition. Proceedings of the AAAI Conference on Artificial Intelligence, 38(9), 10341–10349. https://doi.org/10.1609/aaai.v38i9.28901
Hausler, S., & Moghadam, P. (2025). Pair-VPR: Place-aware pre-training and contrastive pair classification for visual place recognition with vision transformers. IEEE Robotics and Automation Letters, 10(4), 4013–4020. https://doi.org/10.1109/lra.2025.3546512
Yu, Z., Xu, Q., Jiang, Y., Sun, Y., & Huang, Q. (2024). Enhancing sample utilization in noise-robust deep metric learning with subgroup-based positive-pair selection. IEEE Transactions on Image Processing, 33, 6083–6097. https://doi.org/10.1109/tip.2024.3482182
Li, H., Peng, G., Zhang, J., Wen, M., Ma, Y., & Wang, D. (2025). CaseVPR: Correlation-aware sequential embedding for sequence-to-frame visual place recognition. IEEE Robotics and Automation Letters, 10(4), 3430–3437. https://doi.org/10.1109/lra.2025.3541452
Grainge, O., Milford, M., Bodala, I., Ramchurn, S. D., & Ehsan, S. (2024). Design space exploration of low-bit quantized neural networks for visual place recognition. IEEE Robotics and Automation Letters, 9(6), 5070–5077. https://doi.org/10.1109/lra.2024.3386459
Hu, Z., Liao, L., & Lin, W. (2026). SRD2-VPR: Semantics-enforced feature aggregation with query rejection for visual place recognition. IEEE Transactions on Circuits and Systems for Video Technology, 36(5), 6934–6949. https://doi.org/10.1109/tcsvt.2026.3651681
Soncini, N., Civera, J., & Pire, T. (2025). Addressing the challenges of loop detection in agricultural environments. Journal of Field Robotics, 42(1), 346–355. https://doi.org/10.1002/rob.22414
Melekhin, A., Yudin, D. A., Petryashin, I., & Bezuglyj, V. (2025). MSSPlace: Multi-sensor place recognition with visual and text semantics. IEEE Access, 13, 177098–177110. https://doi.org/10.1109/access.2025.3618728
